
El camión que llegó el martes
La semana pasada cerré con un camión. Llegaba un martes de marzo a la sede norte de Objectville con cinco mil litros de tomate triturado que nadie había pedido. Mezclados con la mercancía buena. Lote MZ-7842-IT. Proveedor BLUE-LINE.
Os dejé tres preguntas: ¿lo devuelves? ¿Lo dejas en cuarentena con etiqueta visible? ¿Lo aceptas con marca de “rechazado” para que dentro de seis meses puedas reconstruir qué pasó?
La respuesta corta es: no es una de las tres. Son las tres a la vez, gobernadas por una sola política. Y la política no la firma un comité — la ejecuta una pieza de la plataforma que todavía no he nombrado pero que llevamos toda la serie dejando huella.
Hoy entro a contestar. Y voy a empezar por el principio doctrinal que sostiene todo lo que sigue, y por el primer ejemplo concreto de la pieza en operación. La huella que deja el camión BLUE-LINE — y dónde queda — la veremos el martes que viene. Hoy entendemos el motor.
La cocina del jueves
Saltemos del muelle a la cocina. Jueves por la tarde, sede de Objectville en una pequeña ciudad costera del Mediterráneo. Llega la mercancía habitual y, dentro, una caja nueva: “Tomate San Marzano DOP — proveedor habitual — lote nuevo de la cosecha de marzo”. La caja viene con su sello DOP visible, su número de certificación, y la etiqueta del Consorzio del San Marzano dell’Agro Sarnese-Nocerino — el organismo oficial que certifica la denominación de origen.
El chef ve la caja. Sonríe. “Buena cosecha. Vamos a probarlo.” Saca un tomate, lo abre con un cuchillo, lo huele. Y la sonrisa se le va.
— Esto no huele a San Marzano — dice, pasándole el tomate al pinche —. Pruébalo.
El pinche prueba. Frunce el ceño. “Tienes razón. Está dulce. El San Marzano nunca está tan dulce a esta altura del año.”
El chef coge el sello DOP de la caja. Lo mira. El número está. La etiqueta del Consorzio está. Pero algo no cuadra. Llama al operativo logístico de la sede.
— El número de certificación que viene en esta caja, ¿lo verificamos contra el registro del Consorzio o nos fiamos de que esté escrito en la caja?
Silencio al otro lado del teléfono.
— Eh… Lo comprobamos al recibir el envío. Que el número estaba ahí, sí.
— No te he preguntado eso. Te he preguntado si llamamos al Consorzio o consultamos su registro online para confirmar que ese número de certificación corresponde a un lote real de San Marzano DOP de marzo de 2026.
— No. Eso no se hace.
— Pues hoy se va a hacer. Llama y devuelve la caja. Y avisa a la central de que esto se les ha colado.
Resulta que el número de certificación era válido — pertenecía a un lote real del Consorzio. Pero a un lote del año pasado, ya consumido. El proveedor — sin saberlo o sabiéndolo, daba lo mismo — había puesto un número antiguo en una caja nueva. Tomate San Marzano de verdad, sí. DOP de verdad, no.
La central de Objectville había firmado en enero un contrato común que dice cosas como esta: “En esta cadena, el tomate marcado DOP debe venir de Campania, ser variedad San Marzano, y llevar certificación DOP vigente con número visible en la caja”. Tres líneas. Bien. Hasta ese jueves.
Ese jueves la cadena va a aprender que tres líneas no eran suficientes. Que iba a hacer falta una cuarta: “Verificación cruzada del número de certificación contra el registro oficial del Consorzio — no basta con que esté escrito en la caja”.
Y aquí está la pregunta que organiza todo lo que viene en este artículo y en el siguiente: ¿cómo aprende una cadena de cuarenta sedes esa cuarta línea sin que cada sede tenga que aprenderla por su cuenta el día que le pase a ella?
La respuesta no es un PDF actualizado. La respuesta no es un correo del comité de calidad de la central. La respuesta es esa pieza. Y tiene nombre concreto.
Eje 1 — Shift left aplicado al modelo: validar antes, no después
La industria del dato lleva dos décadas resolviendo el problema del volumen a costa de la calidad. Big data popularizó el ELT: carga primero, limpia después. La velocidad de ingesta se convirtió en la métrica. La calidad, en el problema de quien consume el dato. El resultado es conocido: datos incorrectos que entran sin marca, se cruzan con otros, se sirven a cinco consumidores, y aparecen en un dashboard de dirección seis meses después. En ese momento ya no hay forma de saber dónde empezó el error ni qué tablas contaminó.
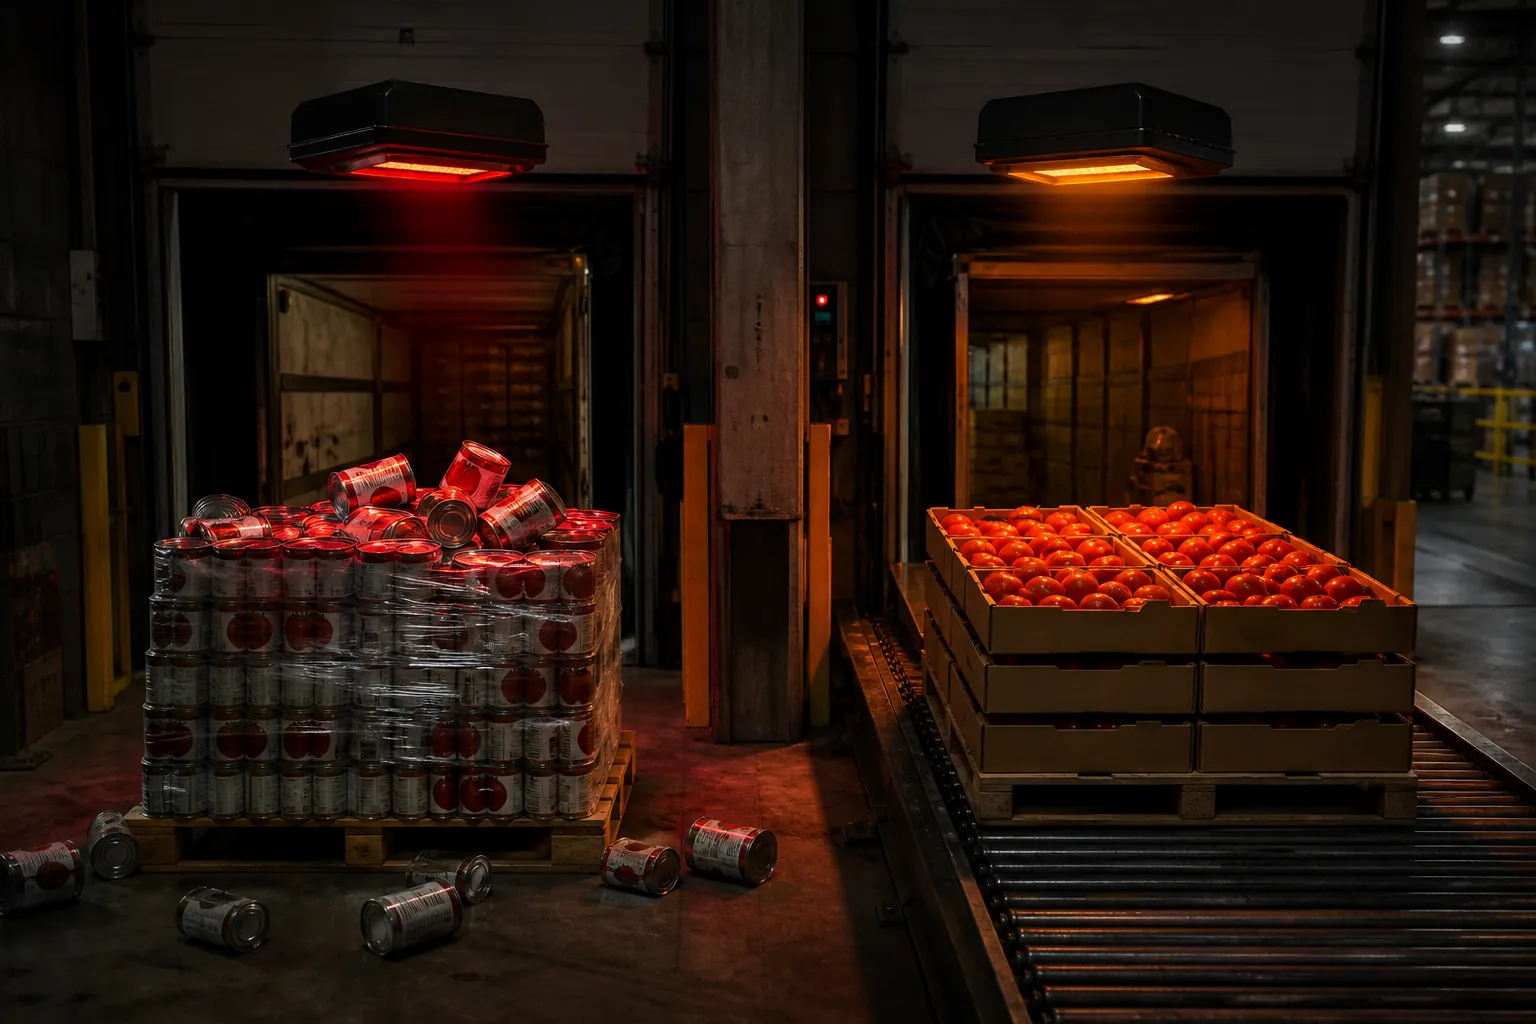
Hay un principio antiguo del software que resuelve exactamente eso. Es shift left: validar a la entrada, no auditar al final. Coercionar antes de cargar, no perseguir errores después de que el dato ya esté esparcido. Pero tampoco es “bloquea todo lo que no sea perfecto” — eso paraliza la carga. El punto medio es: pocas reglas de puerta, claras y no negociables — este dato no puede entrar — más un catálogo de señales de desconfianza que avisan sin bloquear. La diferencia entre los dos tipos de regla es lo que hace que el modelo cargue rápido y sea auditable al mismo tiempo. Una imagen lo clava: si pediste tomate fresco y te traen latas de conserva, cualquiera en el muelle lo detecta sin saber nada de cocina — eso es una regla de puerta, y el lote no entra. Si pediste San Marzano y te traen otra variedad, necesitas a alguien que sepa probarlo — eso es una señal de calidad, el lote entra marcado, alguien lo revisa. La regla de puerta bloquea lo obvio. La señal registra lo que requiere criterio. Las dos son necesarias. Pero solo una para la carga.
Todo lo que hemos descrito hasta aquí — Hubs, Satellites, Links, Shared Kernel ejecutable, reglas pegadas al modelo que se ejecutan en cada carga — es exactamente shift left aplicado al modelo de datos. La diferencia con la mayoría de implementaciones tradicionales no es de tecnología — es de dónde se valida. Si la validación vive en un proceso de auditoría aguas abajo, llega tarde — el dato malo ya entró, ya se cruzó con otros, ya se sirvió a un consumidor, ya está en un dashboard de dirección. Si la validación vive pegada al Hub/Satellite/Link y se ejecuta en cada carga, el dato malo no entra. Y si entra, deja huella estructural inmediata.
Mismo enemigo común: el dato malo aceptado en silencio que se descubre seis meses después. Misma respuesta arquitectónica: coercionar a la entrada, dejar huella, no perseguir errores en logs antiguos. Esa es la doctrina shift-left aterrizada al modelo. Y esa es exactamente la pregunta que da forma al resto del artículo: ¿qué cara concreta tiene el coercionador del dato cuando llega una caja de tomate el jueves a una sede del Mediterráneo?. No abstracto. Operativamente, ¿qué hay en la fábrica que decide si pasa o no pasa? Esa cara tiene nombre.
Eje 2 — El robot validador que aprende: la documentación viva en acción
Si tuviera que elegir una sola pieza de toda la plataforma que estamos contando — una sola, la que más nos diferencia de cualquier implementación tradicional —, no sería el modelo Data Vault. Tampoco el Shared Kernel ejecutable. Tampoco el catálogo de Hubs canónicos. Sería la pieza que está debajo de todas las anteriores y que las hace funcionar de verdad: la documentación viva.
Y aquí es donde tengo que cortar con un malentendido que arrastra el sector desde hace veinte años.
En la mayoría de empresas, “documentación” significa esto: un Confluence con páginas que alguien escribió en 2019, que recogen las reglas de calidad de un dominio en lenguaje natural, y que nadie actualiza. La realidad cambia. Las reglas cambian. La documentación se queda igual. Al cabo de tres años, la documentación describe un sistema que ya no existe. Un PDF que dice “los contratos cancelados deben tener saldo cero” convive con una operativa que el negocio modificó hace tiempo: el redondeo de saldos residuales hasta cinco euros está aprobado desde el Q2 del año pasado. La documentación y la realidad se desincronizan para siempre. Y nadie se da cuenta hasta que un auditor abre el PDF y pregunta.
La documentación viva es exactamente lo opuesto. Y la palabra que la define es la que ya está en el nombre: viva. No descriptiva — operativa. No leída — ejecutada. No mantenida a mano — derivada del código.
Concretamente, la documentación viva tiene tres piezas que viajan juntas, las tres en el repositorio del dominio, las tres versionadas:
- El contrato del dominio — la Recipe — escrita en JSON declarativo, con las entidades, los atributos, las relaciones, y el catálogo de reglas con su severidad.
- Los modelos generados — el código SQL/dbt que la plataforma genera a partir de la Recipe, que carga el dato en el Hub/Satellite/Link siguiendo el contrato.
- Los tests ejecutables — los mismos del catálogo de reglas, derivados automáticamente de la Recipe, que se lanzan cada noche antes de publicar el dato y que contestan a la pregunta que toda cadena necesita contestar todos los días: “¿lo que hay en el modelo cumple lo que el contrato dice que tiene que cumplir?”
Las tres piezas son la misma cosa expresada en tres lenguajes. La Recipe la firma negocio en su idioma. Los modelos los ejecuta la plataforma en SQL. Los tests los lanza el orquestador cada noche. Las tres dicen lo mismo. Las tres se mueven juntas. Cuando una cambia, las otras dos cambian a la vez — automáticamente, no por buena voluntad de un equipo.
Esa es la diferencia operativa. Cuando alguien actualiza el contrato — añade una regla nueva, refina una severidad, modifica un atributo —, el cambio se propaga a los otros dos lados sin pedir permiso. La documentación nunca puede desincronizarse de la realidad porque la realidad es la documentación ejecutada.
Y aquí es donde aterriza el robot validador que da título al artículo. No es un robot literal. Es esa pieza — la documentación viva como mecanismo activo — vista en operación. Un proceso que cada noche lee el catálogo de reglas, lo ejecuta contra el dato del día, y deja una huella estructural de cada decisión. Una pieza que no se cansa, no se le olvida una regla, no salta una validación porque ese día tenía prisa. Y que aprende — cada vez que el negocio refina el catálogo, el robot aprende sin que nadie tenga que reinstalar nada.
Antes de seguir, voy a aterrizar la primera ficha del cuaderno de fábrica.
Ficha 1 — Receta firmada del Tomate San Marzano DOP (versión 1, firmada el 12 de enero)
INGREDIENTE         : Tomate San Marzano DOP
FIRMA EL CONTRATO   : Dirección de Calidad de la cadena
VIGENTE DESDE       : 2026-01-12
REGLAS DE PUERTA    :
  R1 — origen           = Campania (Italia)               · severidad: CRITICAL
  R2 — variedad         = San Marzano                     · severidad: CRITICAL
  R3 — certificación    = DOP visible en la caja          · severidad: CRITICAL
ACCIÓN si CRITICAL  : devolución del lote al productor con motivo
ACCIÓN si WARNING   : aceptar y marcar para revisión humana
ACCIÓN si INFO      : aceptar y dejar huella en QSAT
Esa ficha vive en el repositorio del dominio Productos. Es código. Se puede leer en una pantalla. Es la versión legible del contrato JSON. Y cuando el lunes 12 de enero un proveedor entrega el primer lote del año con el sello DOP, esa ficha se ejecuta — la plataforma comprueba R1, R2 y R3, y deja huella en el QSAT (la pieza que veremos el martes que viene). Si todas pasan, el dato entra. Si alguna falla con severidad CRITICAL, el lote se devuelve con motivo.
Hasta el jueves 18 de marzo, esa ficha funciona. Se ejecuta cada noche con cada lote que llega de cada proveedor de cada sede. Sale verde en miles de comprobaciones.
Y entonces llega el chef del Mediterráneo con su llamada.
— No es San Marzano DOP — me lo dice mi paladar, y el sello dice que sí. Algo en el sello no se está mirando.
El chef tiene razón. La ficha verifica que el sello esté en la caja, pero no verifica que el sello sea válido contra el registro oficial del Consorzio. La regla que ya existe es correcta — pero incompleta. Y aquí está el patrón doctrinal que quiero clavar antes de cerrar hoy: el catálogo de reglas no se instala perfecto el día uno. Se construye queja a queja. Se refina con la realidad. Crece con el negocio, no contra el negocio.
Y traducido al dato.
En la Semana 5, cuando hablamos del pase del chef — la pieza de la cocina donde el chef revisa los platos antes de que salgan al comedor —, di un ejemplo del dominio Cuentas: “Si un contrato cancelado tiene saldo de 500.000€, no me lo creo”. La regla viva la firma negocio. Tres palabras: “si estado = CANCELADO, entonces saldo = 0”. La plataforma la ejecuta cada noche contra todos los contratos cancelados del día. Si encuentra uno con saldo distinto de cero, el sistema dispara — el plato no sale al comedor hasta que alguien lo investiga.
Es la misma pieza. La misma documentación viva. El mismo mecanismo. Solo cambia el dominio: en cocina es Tomate San Marzano DOP; en banca es Cuenta cancelada con saldo. El robot validador es el mismo.
Y la ficha original — “si estado = CANCELADO, entonces saldo = 0” — es la versión 1 de esa regla en el dominio Cuentas. Tres palabras. Se ejecuta cada noche. Funciona. Hasta el día en que la realidad la pone a prueba.
Lo que viene
Lo que pasa cuando una sede detecta que la regla era incompleta — el chef del Mediterráneo del jueves 18 de marzo — y lo que pasa cuando un proveedor manda un lote duplicado mezclado con la mercancía buena — el camión BLUE-LINE del martes — son las dos preguntas que organizan el martes que viene.
Las preguntas son concretas:
- ¿Cómo aprende el catálogo cuando una sede detecta algo que las reglas no contemplaban?. La V1 era correcta pero incompleta — ¿cómo se actualiza sin parar la cadena, sin convocar a comité, sin notificar a 40 sedes por correo? ¿Y dónde queda la huella de lo que la regla decía antes del 18 de marzo, para que un auditor pueda reconstruirlo?
- ¿Dónde queda la huella estructural cuando una hard rule rechaza un dato — el camión BLUE-LINE de los cinco mil litros — para que dentro de seis meses se pueda reconstruir qué se rechazó, por qué motivo y bajo qué severidad?. ¿Carpeta de logs? ¿Tabla aparte? ¿O hay otra pieza del modelo que ya conocemos sin saberlo, que también es Satellite, también es vocabulario Data Vault, y que registra los eventos de calidad como cualquier otra pieza del aparato?
Y detrás de las dos hay una doctrina intelectual que no se puede saltar — porque resuelve el falso dilema de “o validamos todo y se nos para el negocio, o no validamos nada y entra cualquier cosa” con tres severidades distintas que cualquier responsable de calidad reconoce de inmediato. Esa doctrina tiene autor con nombre y un libro de hace casi dos décadas que sigue siendo el estándar operativo del campo. La nombro el martes.
Vamos a ver qué le pasa a la regla cuando la realidad la pone a prueba. Hasta entonces.